
走到今天,我們已經有:
會使用工具的 Agent
會分工的 Multi-Agent
有權限邊界的 Runtime
但 Agent 變多,不代表 GPU 會自己變多。
假設 Research、Writer、Reviewer 同時都要做推論:
三個 Agent
↓
同一個 Ollama
↓
同一台 GPU
最後還是可能全部塞在同一條推論路徑上。
所以今天換一個問題:
如果有兩台都能跑同一個模型的主機,這些推論請求能不能自動分配?
這次使用已完成配對的兩台機器:
gx10-e46a
→ DGX

ubuntu
→ 2706_203
兩台都準備:
PAIR broker
Ollama
workload manager
scheduler
llama3.2:3b
接著只從 DGX 的 PAIR Endpoint 送出 8 筆並行請求。
Client 不指定節點。
讓 PAIR 自己決定:
這一筆到底在哪台主機執行?
前一版測試曾經透過:
node/select
手動指定執行節點。
這可以證明:
PAIR Endpoint 能把請求送到另一台主機。
但還不能證明:
Scheduler 真的有自行做分配。
因為節點其實是 Client 幫它選好的。
所以今天把這個條件拿掉。
PAIR 保持:
selected = auto
然後對同一個模型送出多筆並行 Request。
成功條件也不只看:
模型有沒有回答
而是回頭檢查官方 PAIR workload history。
必須同時看到:
scheduledOn 出現兩台節點

而且

所有 Workload 都是 completed
這才能回答:
請求最後真的在哪台機器執行?
整條資料路徑可以畫成:
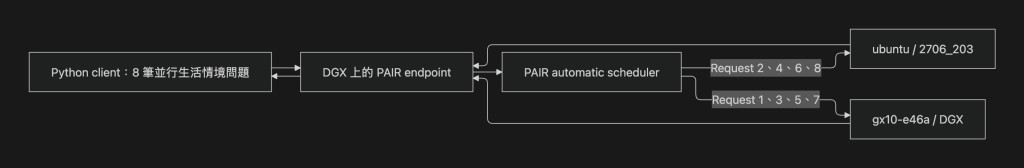
對應用程式來說,它只看到:
一個 Endpoint
真正哪台機器執行,由 PAIR Scheduler 決定。
這裡有一個一定要先講清楚的地方。
今天做的是:
Request A
→ GPU 主機 1

Request B
→ GPU 主機 2
不是:
一筆 Request
→ 同時使用兩台主機的 GPU
更不是:
兩張 GPU 的顯存
→ 自動合併成一大塊 VRAM
PAIR 在今天這個實驗裡,是以:
一筆推論 Request
為排程單位。
每一筆推論最後仍然只會在一個節點上完成。
所以如果今天只送:
1 筆 Request
最後自然只會看到一個:
scheduledOn
要觀察排程效果,就需要像今天一樣準備多筆可以同時執行的工作。
今天真正執行的程式:
"""Day 29:對 PAIR 相容端點送出一批可由 scheduler 分配的並行請求。"""

from __future__ import annotations

from concurrent.futures import (
    ThreadPoolExecutor,
    as_completed,
)
import json
import os
from urllib.request import Request, urlopen


ENDPOINT = os.getenv(
    "PAIR_ENDPOINT",
    "http://127.0.0.1:11435",
).rstrip("/")

MODEL = os.getenv(
    "PAIR_MODEL",
    "llama3.2:3b",
)

REQUESTS = int(
    os.getenv(
        "PAIR_REQUESTS",
        "8",
    )
)


def ask(index: int) -> tuple[int, str]:
    payload = json.dumps(
        {
            "model": MODEL,
            "stream": False,
            "messages": [
                {
                    "role": "user",
                    "content": (
                        "請用一句繁體中文回答:"
                        "晚餐前為什麼要先確認冰箱食材?"
                        f" 這是第 {index} 筆獨立請求。"
                    ),
                }
            ],
        },
        ensure_ascii=False,
    ).encode()

    request = Request(
        f"{ENDPOINT}/api/chat",
        data=payload,
        headers={
            "Content-Type": "application/json"
        },
        method="POST",
    )

    with urlopen(
        request,
        timeout=180,
    ) as response:
        body = json.load(response)

    return (
        index,
        body["message"]["content"].strip(),
    )


def main() -> None:
    print(
        f"送出 {REQUESTS} 筆並行生活情境問題"
    )

    with ThreadPoolExecutor(
        max_workers=REQUESTS
    ) as pool:
        futures = [
            pool.submit(
                ask,
                index,
            )
            for index in range(
                1,
                REQUESTS + 1,
            )
        ]

        for future in as_completed(futures):
            index, answer = future.result()

            print(
                f"#{index}: {answer}"
            )


if __name__ == "__main__":
    main()
這段程式刻意沒有:
node
select
host name
GPU ID
Client 只知道:
PAIR_ENDPOINT
PAIR_MODEL
本次預設 Endpoint:
http://127.0.0.1:11435
實測時再透過環境變數覆寫成:
http://127.0.0.1:11436
模型則固定使用:
llama3.2:3b
前提是兩台候選節點都已經具備同一個模型。
這裡還有一個容易誤會的地方。
程式使用:
ThreadPoolExecutor
不是它在做 GPU 排程。
它只是讓 8 筆獨立的 HTTP Request 在時間上重疊。
也就是:
Python ThreadPool
→ 製造並行 Request

PAIR Scheduler
→ 決定每筆 Request 去哪台節點
兩層工作完全不同。
future 也只負責:
等待自己那筆 Request 回來
它不知道:
gx10-e46a
還是:
ubuntu
最後接走了工作。
實際執行後:
8 / 8 Request
都有收到模型回答。
但這還不夠。
因為即使 8 筆全部都在 DGX 上執行,Client 一樣可以拿到 8 個答案。
所以真正要看的,是 PAIR 自己留下的:
workloads-history.json
裡面會記錄每一筆 Workload 的:
originatedFrom
scheduledOn
開始時間
完成時間
status
其中兩個欄位特別重要。
今天全部 Request 都從 DGX 的同一個 Endpoint 進入。
所以:
originatedFrom
都指向 DGX。
這只能代表:
Request 是從哪裡進來。
真正表示:
這筆 Workload 最後在哪個節點執行。
的是:
scheduledOn
所以不能看到:
originatedFrom = DGX
就以為所有推論都在 DGX 上完成。
入口位置和執行位置,是兩件事。
下圖直接讀取本次 PAIR Broker 產生的:
workloads-history.json
再把:
scheduledOn
裡的節點 UUID 對回主機名稱。
不是預先安排好的示意資料,也不是執行完後人工填出的 Dashboard。
最後結果:
8 / 8 completed
分配如下:
gx10-e46a / DGX
→ #1
→ #3
→ #5
→ #7

ubuntu / 2706_203
→ #2
→ #4
→ #6
→ #8
也就是:
DGX
4 筆

ubuntu
4 筆
同一個 Endpoint 收到一批並行請求後,PAIR 確實把 Workload 排到兩台不同的節點執行。
這才是今天真正需要的證據。
這次剛好看到:
4 : 4
不能因此推論:
PAIR 永遠會一台一筆輪流分配。
今天只能說:
在這一次實測的候選節點、模型、工作量與當下資源狀態下,Scheduler 最後產生了 4:4 的結果。
真正排程時仍然會受到:
可用節點
模型是否存在
目前 Workload
GPU 負載
當下資源狀態
影響。
所以另一輪如果變成:
5 : 3
甚至:
6 : 2
本身不代表 Scheduler 壞掉。
判斷重點應該是:
Client 沒有手動指定節點

Workload 確實被 Scheduler 分派

執行結果可以從官方紀錄追查
而不是一定要平均。
今天的 Demo 用 Python Client 直接打 PAIR Endpoint。
原因是先把:
PAIR Scheduler
單獨驗證清楚。
OpenClaw 真正需要看到的,其實只是一個模型 Endpoint。
原本:
OpenClaw
↓
Ollama
↓
單一主機
之後可以變成:
OpenClaw Agent
↓
PAIR Endpoint
↓
PAIR Scheduler
├── gx10-e46a
└── ubuntu
對上層 Agent 來說:
Research
Writer
Reviewer
都不需要知道:
哪台 GPU 現在有空?
也不需要自己維護:
DGX URL
ubuntu URL
這些資源選擇開始往推論基礎設施層下沉。
這也是今天把 PAIR 放進整個系列的原因。
今天實際走完:
單一 PAIR Endpoint
↓
8 筆並行 Request
↓
Automatic Scheduler
↓
兩台候選主機
↓
模型完成推論
↓
workloads-history.json
↓
回查 scheduledOn
和之前手動:
node/select
相比,多驗證了一層:
Client 不需要先知道該選哪台主機。
而今天沒有做的是:
單次模型跨兩台 GPU
多機合併 VRAM
Tensor Parallel
模型切片
所以最後再記一次:
PAIR 自動分配多筆 Request
≠
把多張 GPU 合併成一張
今天處理的是:
Inference Request Scheduling
不是:
Distributed Model Execution
Day 28 我們處理:
Agent 怎麼被限制
Day 29 再往下一層:
Agent 需要推論時
Request 要去哪台 GPU
走到這裡,整個系列其實已經逐漸串成:
Agent
↓
OpenClaw
↓
Model Endpoint
↓
PAIR Scheduler
↓
GPU Nodes
上層 Agent 不需要知道實際是哪台 GPU 完成推論。
就像前面的 Agent 不需要知道 MCP Server 裡面怎麼開檔案一樣。
責任開始一層一層拆開。
明天就是最後一天。
不再加新的框架,也不再增加新的 Agent。
把過去 29 天重新串成一條完整路線:
Python
↓
MCP
↓
ReAct
↓
Plan-and-Execute
↓
Agent Framework
↓
Security
↓
Multi-Agent
↓
OpenClaw
↓
PAIR
再看看一開始那個:
一台本機 GPU、三十天、零 API 費用。
最後到底做出了什麼。
Day 30:
三十天成果總結:從 MCP 到 Multi-Agent 的可驗證工作流。


 iThome鐵人賽
 看影片追技術